新手做 AI Infra:最关键的 20% 知识
写给刚加入 AI 基础设施团队的新人。不求面面俱到,只挑那些"懂了它,80% 的讨论你都能跟上"的核心概念,每条都讲清楚是什么、为什么重要、怎么算。2026-10 整理。
后面所有知识点,都是在回答同一个问题:GPU 的时间被什么浪费了?
目录
- 全景图:AI Infra 是一座中央厨房
- GPU 的三个数:算力、显存、带宽
- 内存墙:大多数时候不是算不动,是搬不动
- 数字精度:BF16 / FP8 / INT4
- 显存账本:一个模型到底要多少显存
- 推理核心:Prefill、Decode 与 KV Cache
- 推理优化四板斧
- 分布式训练:四种并行
- 集合通信与网络互联
- 软件栈:从 CUDA 到 vLLM
- 集群、调度与故障
- 衡量指标:怎么判断干得好不好
- 必背数字速查表
- 学习路线与自测题
0. 全景图:AI Infra 是一座中央厨房
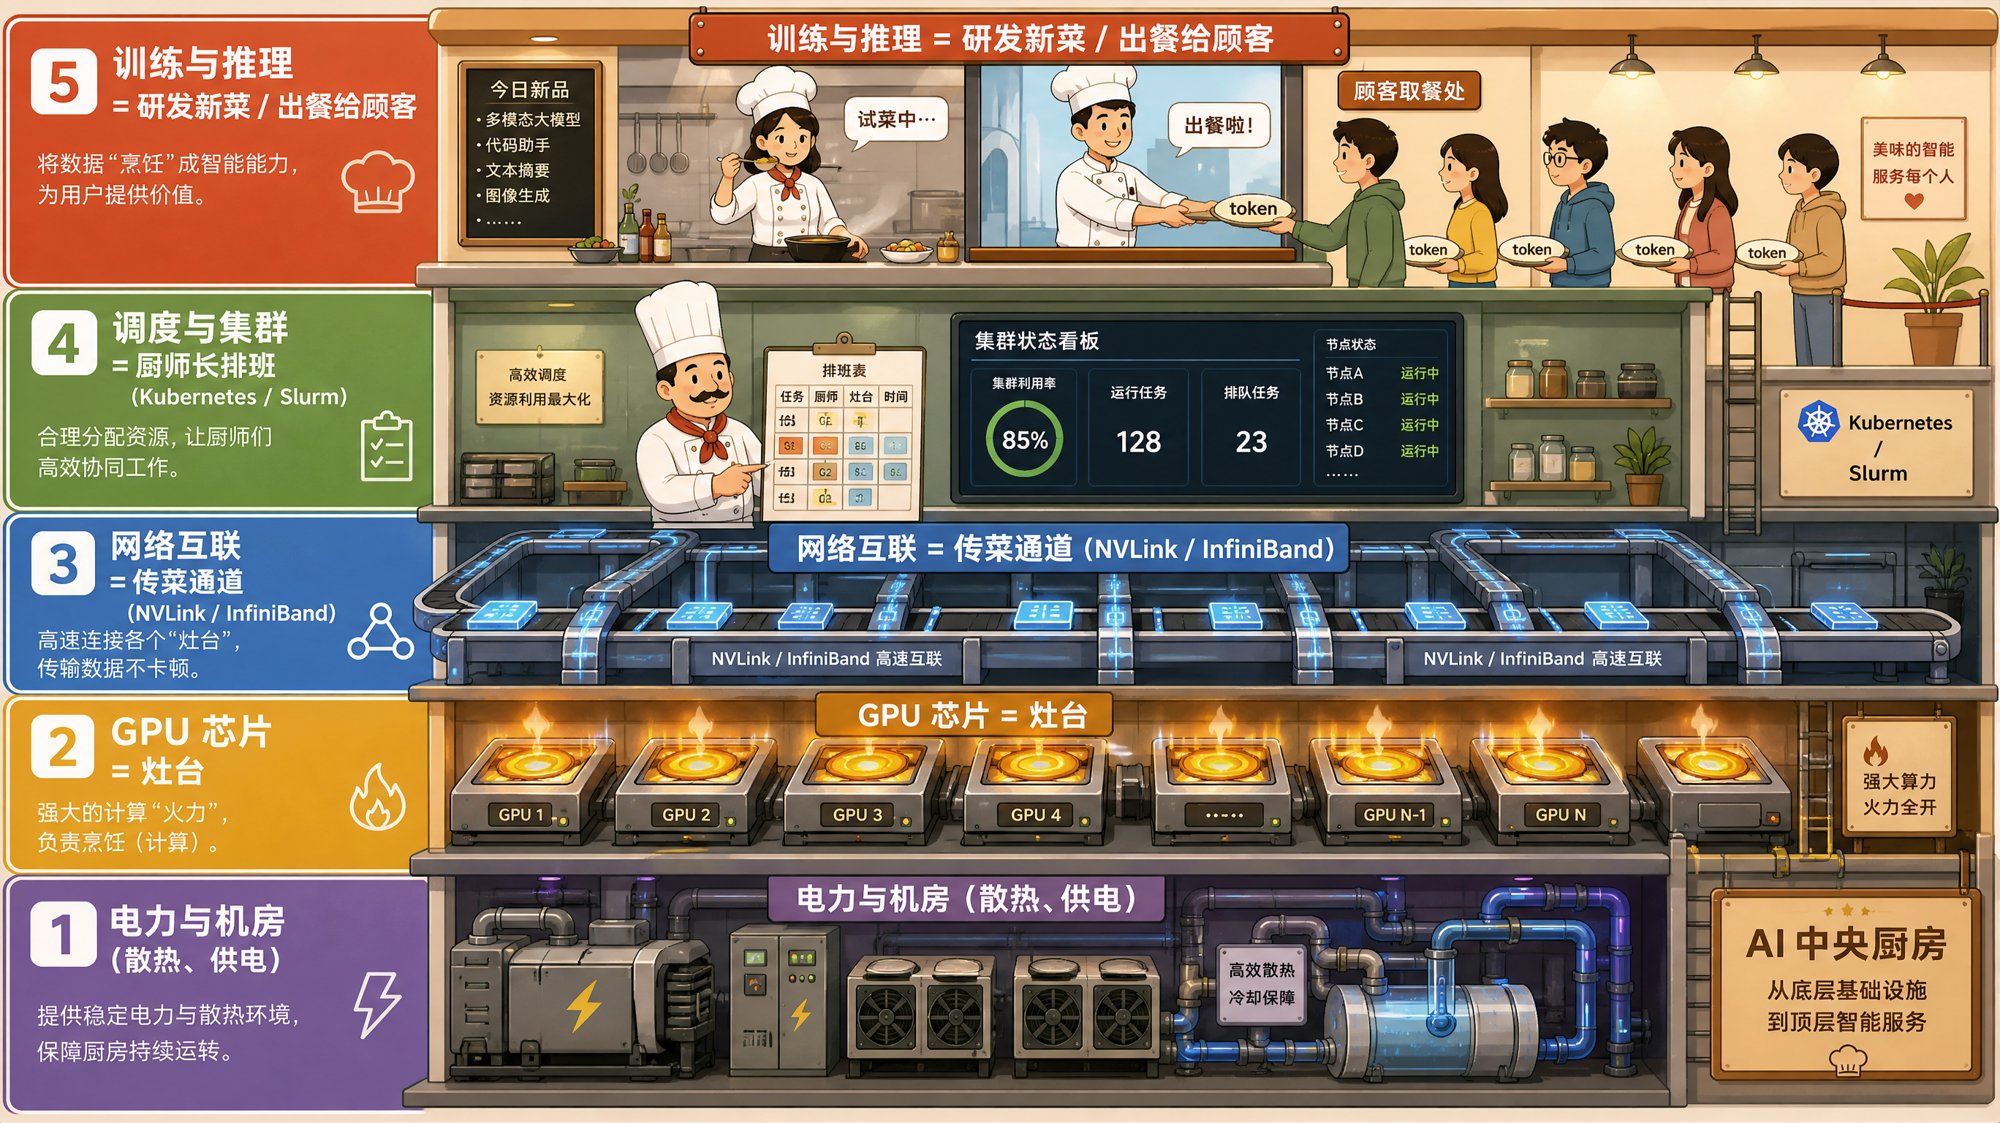
| 层 | 厨房里的比喻 | 真实对象 | 新人要懂到什么程度 |
|---|---|---|---|
| 训练 / 推理 | 研发新菜 / 给顾客出餐 | Megatron、DeepSpeed、FSDP;vLLM、SGLang、TensorRT-LLM | 重点:知道瓶颈在哪、怎么估算 |
| 调度与集群 | 厨师长排班 | Kubernetes、Slurm、Ray | 会用、会排查任务卡住 |
| 网络互联 | 灶台之间的传菜通道 | NVLink、InfiniBand、RoCE、NCCL | 知道带宽层级和通信模式 |
| 芯片 | 灶台 | NVIDIA H100/H200/B200、AMD MI300X、各家 NPU | 重点:算力、显存、带宽三个数 |
| 机房 | 电和水 | 供电、液冷、机柜 | 知道"电力是新的瓶颈"即可 |
训练和推理是两种很不一样的活:
| 训练(研发新菜) | 推理(出餐) | |
|---|---|---|
| 做什么 | 用海量数据反复调整模型参数 | 用训练好的模型回答用户 |
| 规模 | 几百到几万张卡,连续跑几周 | 一个模型几张卡,但同时服务成千上万人 |
| 最怕 | 卡坏了、通信慢、整个任务停下来 | 用户等太久、每个 token 太贵 |
| 核心指标 | MFU(算力利用率)、有效训练时间占比 | 首字延迟、吐字速度、吞吐、每百万 token 成本 |
1. GPU 的三个数:算力、显存、带宽 地基
评价一张 GPU,记住三个数就够了:
- 算力(FLOPS):每秒能做多少次浮点运算。H100 的 BF16 稠密算力约 989 TFLOPS(每秒约 1000 万亿次)。
- 显存容量(HBM):GPU 身上能放多少数据。H100 是 80 GB,H200 是 141 GB,B200 是 192 GB。
- 显存带宽:每秒能从显存搬多少数据到计算核心。H100 约 3.35 TB/s,B200 约 8 TB/s。
为什么用 GPU 不用 CPU?因为神经网络的核心是大矩阵乘法,可以拆成海量互不相关的小乘法同时做。CPU 是几十个"大学教授",GPU 是上万个"小学生"——做加减乘除这种简单题,人多的赢。
2. 内存墙:大多数时候不是算不动,是搬不动 最重要
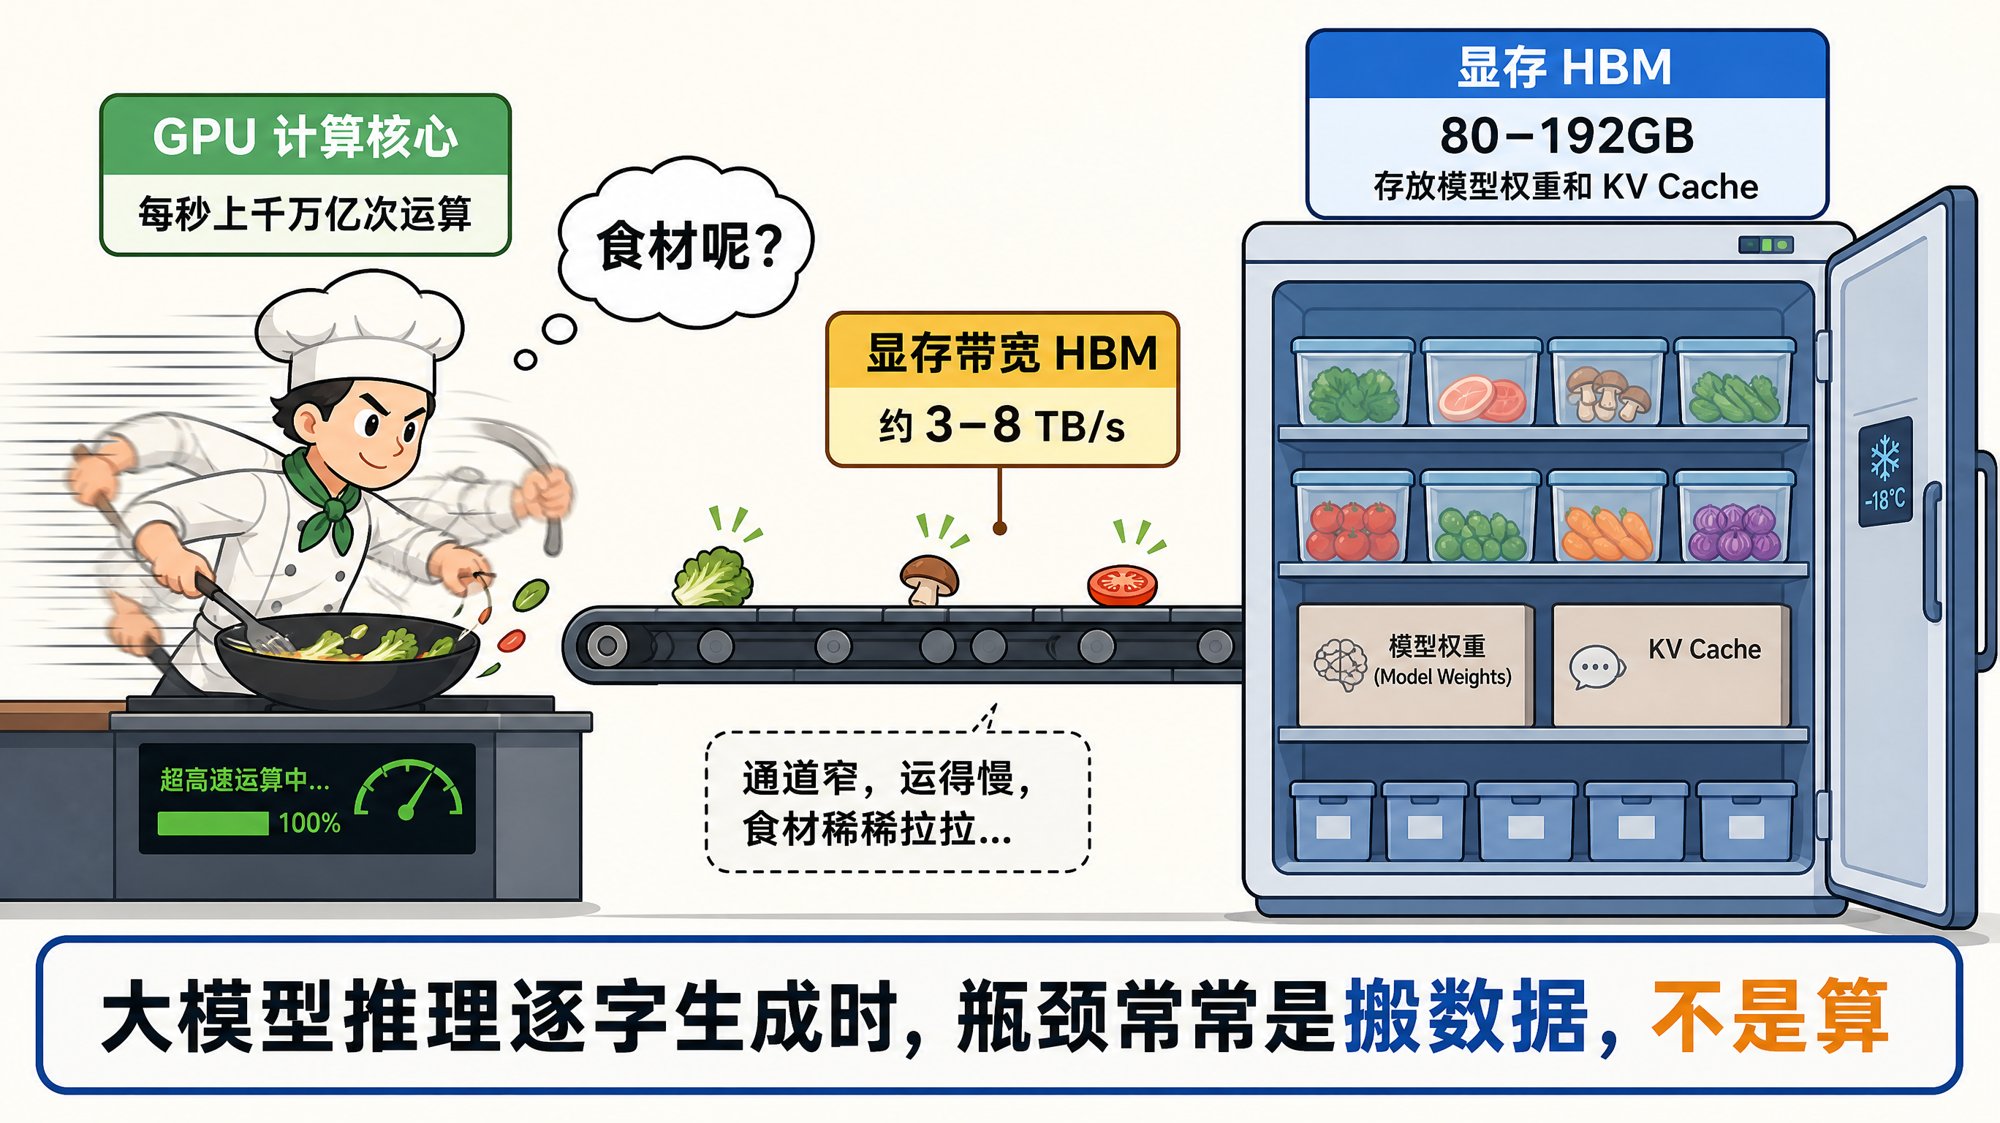
这是整个 AI Infra 里最该先懂的一个概念。算一笔账:
意思是:每从显存搬 1 个字节进来,GPU 得在这个字节上做将近 300 次运算,计算单元才不会闲着。
这个比值叫算术强度(arithmetic intensity)。任务的算术强度低于 ~300 → 卡在搬数据上(访存受限 memory-bound);高于 → 卡在计算上(计算受限 compute-bound)。
Roofline(屋顶线)模型:先爬"斜坡"(带宽限制),再撞"屋顶"(算力限制)
- 推理优化的核心手段(批处理、量化、KV Cache 管理、FlashAttention)本质都是"少搬数据"或"搬一次多用几次"。
- 新 GPU 加带宽(HBM3 → HBM3e)往往比加算力对推理更有用。
nvidia-smi显示 GPU 利用率 100%,可能只说明它"一直在忙着等数据",不代表算力跑满了。
3. 数字精度:BF16 / FP8 / INT4
每个模型参数是一个数字,用多少个字节存它,直接决定显存占用、搬运量和速度。
| 格式 | 每个参数 | 典型用途 | 比喻 |
|---|---|---|---|
| FP32 | 4 字节 | 训练时的"主权重"和优化器状态 | 精确到小数点后很多位的账本 |
| BF16 / FP16 | 2 字节 | 当前训练和推理的默认格式 | 精确到"分" |
| FP8 | 1 字节 | H100 起支持,训练和推理都在推广 | 精确到"元" |
| INT4 / FP4 | 0.5 字节 | 量化后推理;B200 原生支持 FP4 | 精确到"十元" |
4. 显存账本:一个模型到底要多少显存 必会估算
推理:权重 + KV Cache
例:70B 模型 × BF16(2 字节)= 140 GB → 一张 H100(80 GB)放不下,至少两张;量化成 INT4 后约 35 GB,一张就够。
还要给 KV Cache(下一节讲)和运行时开销留空间,通常再预留 20%–50%。
训练:远比推理吃显存
用 Adam 优化器 + 混合精度训练时,每个参数大约要 16 字节:
这就是为什么需要第 7 节的 ZeRO / FSDP:把这 16 字节拆到很多张卡上分摊。
5. 推理核心:Prefill、Decode 与 KV Cache 推理必懂
大模型回答问题分两个阶段:
KV Cache:模型的"草稿纸"
生成第 100 个字时,模型要"回看"前面 99 个字。如果每次都从头重算,就太浪费了。所以把前面每个字算出的中间结果(Key 和 Value)存下来,这就是 KV Cache。
Llama-3-8B:2 × 32 × 8 × 128 × 2 字节 = 128 KB / token
一个 8K 长度的对话 ≈ 1 GB;同时服务 64 个这样的对话 ≈ 64 GB——比模型权重本身(16 GB)还大得多。
6. 推理优化四板斧
- 批处理(Batching):搬一次权重,同时给 64 个用户各算一个 token,单位成本骤降。现代引擎用连续批处理(continuous batching):谁答完谁走,新请求随时插队,GPU 不空转。
比喻:一锅炒 64 份,而不是一份一份炒。 - KV Cache 管理:vLLM 的 PagedAttention 像操作系统的虚拟内存一样把 KV Cache 切成小页,消除碎片;前缀缓存让同样开头的提示词(如系统提示)只算一次。
- 量化:权重/KV 用 FP8 或 INT4 存,搬得更少,能放更多。
- 投机解码(Speculative Decoding):用一个小模型先猜几个字,大模型一次性验证。猜对了等于一步出好几个字。
比喻:实习生先打草稿,主厨一眼扫过去批量通过。
进阶方向:Prefill / Decode 分离部署(两种阶段特性相反,放不同机器上各自优化)、FlashAttention(把注意力计算的中间结果留在片上高速缓存,不来回搬显存)。
7. 分布式训练:四种并行 训练必懂
一张卡放不下、算不完,就要拆到很多卡上。拆法只有四种基本思路:
② 张量并行:一道菜几个厨师同时切同一块肉,配合要极其紧密(必须挨着站)。
③ 流水线并行:洗菜→切菜→炒菜→装盘,每人负责一道工序。
④ 专家并行:川菜师傅、粤菜师傅、甜点师傅,每道菜只找对口的师傅。
ZeRO / FSDP 是数据并行的升级版:不再每张卡都存完整的"16 字节/参数",而是把权重、梯度、优化器状态切片分摊到所有卡上,用到时再临时拼回来——用通信换显存。
实际大模型训练是组合拳(3D/4D/5D 并行):机内用 TP,跨机用 PP 和 DP,MoE 再加 EP,长上下文再加序列/上下文并行(CP)。
例:7B 模型训 2T token = 6 × 7×10⁹ × 2×10¹² ≈ 8.4×10²² FLOPs。H100 按 40% 利用率算约 400 TFLOPS/卡 → 约 5.8 万卡·小时 ≈ 1000 张卡跑 2.4 天。
8. 集合通信与网络互联
多卡协作时,卡之间要频繁交换数据。几种标准"交换动作"叫集合通信:
- AllReduce:大家各有一份数,求和后每人都拿到总和(数据并行同步梯度用)。
- AllGather / ReduceScatter:拼起来分给每人 / 求和后每人只拿一片(FSDP 用)。
- All-to-All:每人给每人发不同的东西(MoE 专家路由用)。
NVIDIA 的实现库叫 NCCL(读作 "nickel"),训练卡住时日志里最常见的就是它。
带宽阶梯:越往外越慢
9. 软件栈:从 CUDA 到 vLLM
| 层 | 代表 | 一句话 |
|---|---|---|
| 应用框架 | Megatron-LM、DeepSpeed、TorchTitan;vLLM、SGLang、TensorRT-LLM | 训练 / 推理的"成品厨房",你最常打交道的一层 |
| 深度学习框架 | PyTorch(绝对主流)、JAX | 写模型的语言 |
| 算子 / 编译 | FlashAttention、Triton、torch.compile、CUTLASS | 把计算写得又快又省搬运 |
| 加速库 | cuBLAS、cuDNN、NCCL | 矩阵乘、卷积、通信的官方高性能实现 |
| 底层 | CUDA、GPU 驱动(AMD 对应 ROCm) | 直接指挥 GPU |
两个关键概念:
- Kernel(算子 / 内核):GPU 上执行的一个函数,如"一次矩阵乘"。
- Kernel 融合:把好几步合成一个 kernel,中间结果不写回显存——又一次"少搬数据"。FlashAttention 就是最成功的例子。
10. 集群、调度与故障
- 调度器:Slurm(训练/超算界传统)和 Kubernetes(云原生、推理服务主流),加上 Ray 等。核心问题:谁用哪些卡、排队顺序、整组卡同时分配(gang scheduling——分布式训练必须全员到齐才能开工)、尽量把一个任务的卡放在网络拓扑上相邻的位置。
- 容器:Docker 镜像打包好 CUDA + 框架,解决"我这能跑你那不能跑"。
- 故障是常态:上万张卡的集群,几乎每天都会有卡掉线、显存 ECC 错误、网口抖动。大规模训练任务平均几小时就可能被打断一次。
- Checkpoint(存档):定期把训练状态存盘,坏了从最近的存档恢复。存档要快(几百 GB 到几 TB)、恢复要快、坏节点要能自动摘除和替换。
11. 衡量指标:怎么判断干得好不好
| 场景 | 指标 | 含义 | 大概水平 |
|---|---|---|---|
| 训练 | MFU(模型算力利用率) | 实际有效算力 ÷ 硬件峰值算力 | 大模型训练 30%–50% 算不错 |
| 有效训练时间占比(goodput) | 扣掉故障、重启、存档后真正在训练的时间 | 越接近 100% 越好 | |
| 推理 | TTFT | 首字延迟:发出问题到看到第一个字 | 交互场景通常要几百毫秒内 |
| TPOT / ITL | 后续每个字的间隔 | 人眼阅读舒适约每秒 20+ token | |
| 吞吐 | 整台机器每秒总共吐多少 token | 和延迟此消彼长 | |
| 每百万 token 成本 | 最终的商业指标 | 一切优化最后都折算成它 |
必背数字速查表
| 项目 | 数字 | 用来干嘛 |
|---|---|---|
| H100 SXM | 80 GB HBM3 · 3.35 TB/s · ~989 TFLOPS BF16 | 行业基准卡,估算都拿它当单位 |
| H200 | 141 GB · 4.8 TB/s(算力同 H100) | 主要升级显存和带宽 → 推理更爽 |
| B200 | 192 GB HBM3e · ~8 TB/s · ~2.25 PFLOPS BF16,支持 FP4 | 当前主力新一代 |
| 推理权重显存 | 参数量 × 2 字节(BF16) | 70B → 140 GB |
| 训练显存 | 参数量 × ~16 字节 + 激活 | 7B → 112 GB+ |
| 训练计算量 | 6 × N × D | 估卡数、估天数、估钱 |
| 推理计算量 | 每 token ≈ 2 × N | 估推理算力需求 |
| 单用户 decode 速度上限 | 显存带宽 ÷ 权重大小 | 8B on H100 ≈ 200 token/s |
| KV Cache / token | 2 × 层数 × KV头数 × 头维度 × 字节 | Llama-3-8B ≈ 128 KB |
| 带宽阶梯 | HBM TB/s > NVLink ~1 TB/s > PCIe ~64 GB/s > IB ~50 GB/s | 决定并行怎么摆 |
注:硬件数字为厂商公开的 SXM 版本规格(稠密、不含稀疏加速),不同形态(PCIe 版、NVL 版)会有差异,用于估算量级足够。
学习路线与自测题
建议顺序(每步都动手)
- 第 1 周:在一张卡上用 vLLM 部署一个 7B/8B 模型,用压测工具测 TTFT、TPOT、吞吐,改 batch 和最大并发看指标怎么变。→ 吃透第 1、2、5、6 节。
- 第 2 周:用
nvidia-smi、nvtop、PyTorch Profiler / Nsight Systems 看 GPU 到底在干嘛;手算显存,再和实际占用对比。→ 第 3、4 节。 - 第 3–4 周:用 PyTorch FSDP 在 2–8 张卡上训一个小模型,故意弄出 OOM、改并行配置、观察 NCCL 通信。→ 第 7、8 节。
- 之后:读 vLLM / SGLang 源码中调度器部分;读 Megatron-LM 并行配置;参与一次线上故障复盘。→ 第 9–11 节。
推荐材料
- Hugging Face《The Ultra-Scale Playbook》:分布式训练最好的入门长文,图多。
- Google《How to Scale Your Model》(JAX 团队,"scaling book"):Roofline 和并行的系统讲解。
- vLLM 论文(PagedAttention, SOSP 2023)与 FlashAttention 论文:推理优化两篇奠基之作。
自测题(能答出来,就掌握了这 20%)
1. 为什么单用户聊天时 GPU 算力利用率很低?
Decode 阶段每出一个 token 都要读一遍全部权重,计算量却很小,是访存受限,算力在等数据。办法是批处理:搬一次权重给很多用户同时算。
2. 70B 模型 BF16 推理至少几张 H100?INT4 呢?
权重 140 GB → 至少 2 张(实际要留 KV Cache 空间,常用 4 张或 8 张做张量并行);INT4 约 35 GB → 1 张能放下,剩余空间给 KV Cache。
3. 为什么 7B 模型在一张 80 GB 卡上推理很轻松,训练却放不下?
推理只要权重 14 GB;训练每参数约 16 字节(权重、梯度、FP32 主权重、Adam 两个状态)≈ 112 GB,还要加激活。需要 ZeRO/FSDP 分摊到多卡。
4. 张量并行为什么一般不跨机器?
它每一层都要做通信,通信量大且频繁,只有机内 NVLink(~1 TB/s)扛得住;跨机 IB 每卡约 50 GB/s,慢一个数量级以上。
5. 长上下文为什么贵?
KV Cache 随上下文长度线性增长,占满显存后能同时服务的用户就少了;prefill 的注意力计算量还随长度平方增长。
6. 1000 张 H100 训一个 7B 模型 2T token 大概要多久?
6 × 7e9 × 2e12 ≈ 8.4e22 FLOPs;每卡按 40% MFU ≈ 4e14 FLOPS,1000 卡 ≈ 4e17 FLOPS → 约 2.1e5 秒 ≈ 2.4 天(不含故障损失)。
① GPU 很快,数据搬运才是常见瓶颈——优化几乎都是"少搬、搬一次多用"。
② 显存要能算账:推理 = 权重 + KV Cache;训练 ≈ 16 字节/参数 + 激活。
③ 多卡要按带宽阶梯摆:通信越频繁,放得越近;规模越大,越要防故障。